Teil 5: Nutzung und Wirtschaftlichkeit von Open Source Software Defined Storage für kleine und…
Ceph wurde erstmalig 2007 an der University of California in Santa Cruz von Sage A. Weil in seiner Dissertation mit dem Titel: »CEPH: RELIABLE, SCALABLE, AND HIGH-PERFORMANCE DISTRIBUTED STORAGE«,...
Open Source SDS Ceph
Ceph wurde erstmalig 2007 an der University of California in Santa Cruz von Sage A. Weil in seiner Dissertation mit dem Titel: »CEPH: RELIABLE, SCALABLE, AND HIGH-PERFORMANCE DISTRIBUTED STORAGE«, definiert.
Ceph basiert auf einem verteilten, autonomen und redundant nativen Object Store namens RADOS.
RADOS steht für:
»Reliable Autonomic Distributed Object Store«
Ceph mit RADOS ist ein nahtlos skalierender Object Store. Ein Object Store ist ein Speicheradressraum, der beliebig groß, ortsunabhängig und dynamisch wächst oder schrumpft. Er fasst den Speicherraum von beliebig vielen Festplatten transparent zusammen. Der Object Store stellt den Anwendungen Abschnitte des Speicheradressraumes über einen eindeutigen Namen (ID) zur Verfügung.
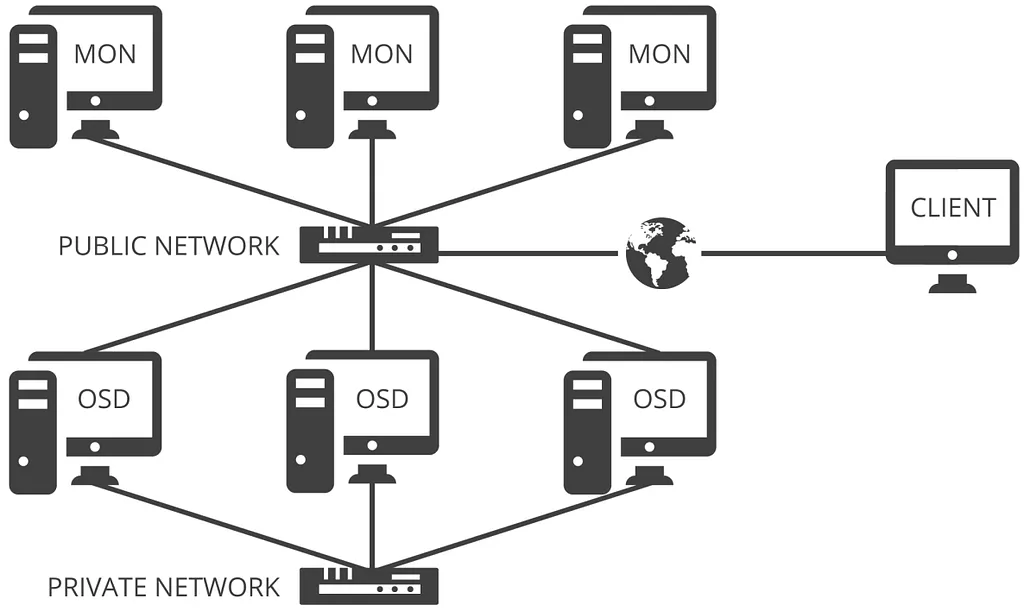
Zugang über Netzwerk (auch Internet).
Skalierbarkeit
Bevor auf die Funktionsweise eingegangen wird, ist nachfolgend die Skalierbarkeit im Kontext von Ceph erklärt.
Die Skalierbarkeit beschreibt die Erweiterung von Leistung mit Hinblick auf die Leistungsdimension (CPU, RAM, Storage). Die Skalierbarkeit in Ceph bezieht sich auf die Storage Erweiterung, indem neue Festplatten einem Storage Cluster hinzugefügt werden.
Die Skalierung unterscheidet zwei wesentliche Arten:
Vertikale Skalierung (Scale Up)
Die Leistungserweiterung erfolgt in einem Rechner durch das Hinzufügen oder Ersetzen von leistungsstärkeren Komponenten. Diese Art der Skalierung stößt natürlich baubedingt an ihre Grenze.
Horizontale Skalierung (Scale Out)
Zusätzliche Rechner werden miteinander verbunden und können, mit Hinblick auf Ceph, umfangreiche Daten auf mehreren Systemen verteilen.
Funktionsweise
Im Wesentlichen besteht RADOS aus zwei Komponenten:
Den sogenannten Object Storage Demons (OSDs) und den Monitoring Servern (MONs).
OSDs sind standardmäßig einzelne Festplatten, die auf Hardwareebene nicht im RAID Verbund konfiguriert werden sollten, da sich Ceph um die Redundanz kümmert.
Monitoring Server (MONs), haben drei Hauptaufgaben.
- Überprüfung und Pflege der inneren Struktur eines Clusters.
- Prüfen der gegenseitigen Erreichbarkeit und ermitteln, ob sie Teil einer Cluster Partition sind.
- Führen eines Protokolls über vorhandene MONs und OSDs, indem sie OSD und MON Maps erstellen, die Informationen aller vorhandenen OSDs und MONs an den Client weitergeben.
MONs sind auch der “Initial Points of Contact” für jeden Client, der auf Block Storage innerhalb eines Ceph Cluster zugreifen will.
Data Placement
Eine Anwendung (Client) muss zu einem MON (oder Gateway) Kontakt aufnehmen, um eine Object Store Übersicht zu bekommen. MONs benötigen statische IP Adressen/ FQDNs, damit Clients zu ihnen zuverlässig Verbindungen aufbauen können, um Daten zu speichern.
Zum Speichern zerlegt der Client die Daten in binäre Objekte und organisiert diese in Gruppen, den sogenannten Placement Groups.
Mithilfe der Placement Groups verteilt der Client die binären Objekte auf die zu den Placement Groups gehörenden OSDs und weiß deshalb immer, welche Objekte zu welchen OSDs gehören.
Der Speichervorgang ist parallelisiert und damit auch bei langsamerer Hardware immer noch schneller als die gewöhnliche Blockspeicherung.
Redundante Speicherung
Der Client kümmert sich nicht darum Daten redundant zu speichern. Diese Aufgabe übernehmen OSDs automatisch und teilen die dafür notwendige Arbeit unter sich auf. Der Client schreibt das zu speichernde Objekt nur einmal auf den Primary OSD bzw. die zur Placement Group gehörende Festplatte. Die Replikation zwischen den OSDs wird vollständig autonom ausgeführt.
Woran macht Ceph fest, welche OSDs die Ziele für eine bestimmte
Placement Group sind?
Im Gegensatz zu anderen Datenspeichersystemen, die z. B. Hash Tabellen für das Data Placement nutzen, um zu bestimmen, welche Objekte auf welchen Servern gespeichert werden müssen, nutzt Ceph dafür den speziell entwickelten CRUSH Algorithmus. CRUSH verhindert Engpässe beim Abfragen von Speichermetadaten, die normalerweise auftreten, wenn nur normale Hash Tabellen verwendet werden.
CRUSH steht für:
»Controlled Replication Under Scalable Hashing«
Der CRUSH Algorithmus arbeitet pseudozufällig. Das heißt, für jede im Cluster existierende Placement Group bestimmt CRUSH eine zufällige aber reproduzierbare OSD Liste, die zur Placement Group gehört. Der Client ermittelt also über eine Berechnung, die zur Placement Group gehörenden primären und sekundären OSDs. Defekte OSDs werden vom CRUSH Algorithmus ignoriert.
Die Zuweisung der Objekte zu den zugehörigen Speicherorten erfolgt rein rechnerisch und ist deshalb um ein vielfaches leistungsfähiger. Administratoren können das Data Placement über den CRUSH Algorithmus beeinflussen. Das bedeutet, sie können entscheiden welche OSDs in welchen Rechenzentren bzw. welche OSDs aus unterschiedlichen Racks bei einem Replikationsvorgang verwendet werden sollen.
Zu replizierende Objekte müssen vollständig im OSD Journal registriert sein, bevor der Client autorisiert wird den Schreibvorgang der Daten abzuschließen. Lesevorgänge benötigen keine Meta-Informationen, z. B. aus Index Strukturen, um ausgeführt werden zu können. Über die Objekt ID errechnet der CRUSH Algorithmus, auf welchen OSDs das Objekt gespeichert ist.
Fällt eine OSD aus, erzeugt Ceph automatisch Kopien von den noch vorhandenen Replikaten und schreibt sie nach dem Austausch der ausgefallenen OSD auf die ersetzte OSD. Repliziert wird nur auf funktionstüchtige OSDs.
Clients
Anwendungen speichern Daten in Ceph über Interfaces, die von Ceph direkt oder indirekt über das Betriebssystem zur Verfügung gestellt werden.
Ceph bietet File- und Object Storage einen Block Device Driver (RADOS Block Device, RBD), der Speicher in Form einer Festplattenemulation zur Verfügung stellt.
Das RBD gibt es in zwei verschiedenen Varianten:
- Linux Kernel-Modul
Administratoren stellen darüber Ceph Speicherplatz als Festplattenemulation zur Verfügung. Im Linux Betriebssystem erscheint der Ceph Speicher dann als reguläres Linux Device. Z. B. /dev/rbd/ oder /dev/rbd0/ - Qemu-RBD Modul
Qemu-RBD ist ein Storage Treiber für Qemu und stellt virtuellen Servern (VMs) Ceph Speicher als virtuelle Festplatte zur Verfügung.
Ceph Speicher kann auch über eine RESTful API genutzt werden, worüber Anwendungen direkt über das HTTP Protokoll Zugriff auf Ceph haben.
Das RADOS Gateway (radosgw) erlaubt Ceph Daten in Diensten wie Google Drive oder Dropbox zu integrieren. Es bietet eine HTTP Schnittstelle zu Ceph, die auf fastCGI basiert und vom eingesetzten Webserver unterstützt sein muss. Ceph Objekte können dann direkt über ein HTTP Interface genutzt werden.
CephFS ist ein von Ceph zur Verfügung gestelltes Dateisystem, das wie jedes Standard Dateisystem, von Anwendungen genutzt werden kann. Anwendungen können auch direkt mit Ceph kommunizieren, indem sie die Ceph C Bibliothek LIBRADOS einbinden. Für Script-Sprachen, wie z. B. Python werden ebenfalls APIs zur Verfügung gestellt.
Im nächsten Thema geht es um die:
Teil 6: Installation und Konfiguration von Ceph
Vorhergehendes Thema:
Teil 4: Anforderungen und Herausforderungen an Speichersysteme